色を選び、サイズを選ぶ。その操作ひとつで、ECサイトのURLは1本増えています。
条件が3つ揃えば数百通り。誰の目にも触れないページが、静かに量産されていきます。
ただ、全部を消すのが正解とは限りません。その数百通りのなかに、残したほうがいい組み合わせが何本か混ざっています。
絞り込み検索で生まれたURLの扱いは、二択に整理できます。検索結果に出したいのか、出したくないのか。Googleの公式ドキュメントも、この二択で手段を分けて説明しています。難しいのは手段の選択ではなく、「どれを出したいのか」を自分で決める部分です。ここが決まっていないまま、noindexを付けたり外したりして時間だけが過ぎていきます。
この記事では、どの絞り込み条件の組み合わせを残すか、パラメータの順序をどう揃えるか、ページネーションとどう噛み合わせるか、残すと決めたURLに何を書くか。この4つを、自社で判断できる形にして渡します。公式ドキュメントで確認できた内容と、確認できなかった内容は分けて書いています。検索順位が上がることを約束する記事ではありません。
絞り込み検索のSEOとは|条件3つで300通り、並び替えまで入れて3,600通り
絞り込み検索のSEOとは、フィルタ操作で生まれる大量のURLのうち、どれを検索結果に出し、どれをクロールさせないかを決める設計のことです。ファセットナビゲーションとは、色・サイズ・価格帯といった属性で商品一覧を絞り込む仕組みを指します。
規模感を、簡単な掛け算で確認します。色が10、サイズが6、価格帯が5あるだけで、組み合わせは300通り。ここに並び替えが4種類、1ページあたりの表示件数が3種類あれば、3,600通りになります。実際の商品数は変わっていません。増えているのはURLの数だけです。
Google検索セントラルのManaging crawling of faceted navigation URLsでは、URLパラメータで実装されたファセットナビゲーションが「無限のURL空間」を生み出し、2つの損失につながると説明されています。ひとつは過剰クロール。クローラーはそのURLが役に立つかどうかを、実際に取得するまで判断できないため、無駄なURLを大量に取りに来ます。もうひとつは発見の遅れ。無駄なURLに時間を使った分だけ、新しく公開した商品ページや記事の発見が後回しになります。
ここで「じゃあ全部止めよう」と決めるのは、少し早い。止めるべきかどうかは、サイトの規模で答えが変わります。
制御が必要かをまず判定する|規模によっては、触らなくていい
クロールバジェットとは、Googleがそのサイトをクロールできる量と、クロールしたい量の組み合わせで決まる実質的な上限のことです。
Google検索セントラルのOptimize your crawl budgetには、このガイドを読むべきサイトの条件が明記されています。100万ページ以上あって内容が週1回程度更新されるサイト、1万ページ以上あって内容が毎日大きく変わるサイト、そしてSearch Consoleで「検出 – インデックス未登録」に分類されるURLの割合が大きいサイト。この3つのどれにも当てはまらず、公開したページがその日のうちにクロールされているなら、このガイドは読む必要がないとまで書かれています。
自社がどちら側かは、次の3つで判定できます。
- サイト全体のURL数をおおまかに数える。商品数、カテゴリ数、記事数を足した概算で足ります
- Search Consoleのページ インデックス登録レポートを開き、「検出 – インデックス未登録」の件数と、そこに並んでいるURLの中身を見る
- そのURLの多くが、?color= や ?sort= のようなパラメータ付きだったかを確認する
3つ目で手が止まったなら、制御の対象です。逆に、商品数が数百でパラメータ付きURLが未登録欄を占めてもいないなら、いま手を入れる理由は薄いかもしれません。
困っていないなら、触らない。これも判断のひとつです。
分岐は二択|インデックスさせたいか、させたくないか
絞り込みURLの制御とは、生成されたURLをクロールさせるか、インデックスさせるか、そもそも存在させないかを、パターンごとに決めて実装することです。
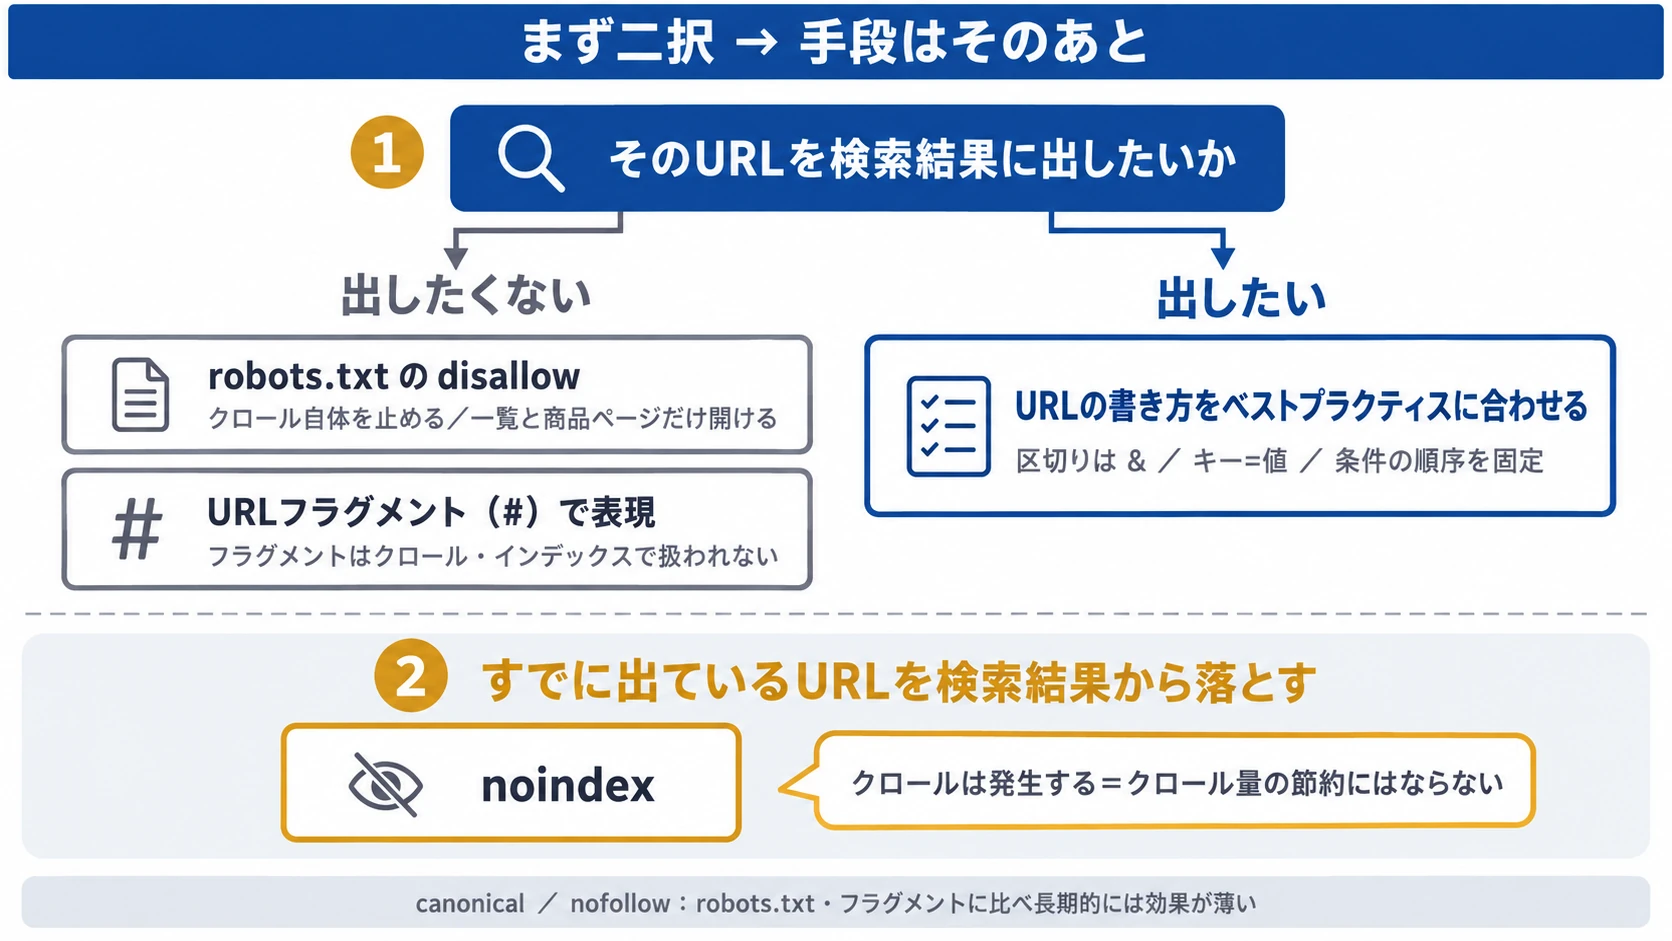
公式の整理はシンプルです。ファセットナビゲーションのURLをインデックスさせる必要がないなら、クロール自体をさせない。インデックスさせたいなら、URLの作り方をベストプラクティスに合わせる。この二択が先にあって、手段はそのあとに決まります。
手段ごとに、効き方は違ってくるでしょう。
- robots.txt の disallow: クロールを止めます。公式は、フィルタ済みの一覧をクロールさせる理由は多くの場合なく、個別商品ページとフィルタなしの一覧ページだけをクロールさせれば足りる、という考え方を示しています
- noindex: クロールは起きます。クローラーがページを取得し、タグを読んでから落とす動きになるため、クロール量の節約にはならないと公式が明記しています
- rel=”canonical” と rel=”nofollow”: 公式は、robots.txtでのブロックとURLフラグメントによる方法と比べて、長期的には効果が薄いと書いています。nofollowはそのURLを指すすべてのリンクに付いていないと効きません
- URLフラグメント(#以降)で絞り込みを表現する: Google検索は一般にフラグメントをクロール・インデックスで扱わないため、クロールへの影響が出ません
そして、重ねてはいけない組み合わせがあります。robots.txtでブロックしたURLにnoindexを書いても、クローラーはそのページを取得できないのでnoindexを読めません。Block Search indexing with noindexには、この状態では他サイトからリンクされている場合などに検索結果へ表示され得ると書かれています。robots.txtファイル内でnoindexを指定する書き方も、Googleはサポートしていません。
canonicalそのものの考え方や重複コンテンツの基本は、テクニカルSEOとは?検索順位を上げるための基本と実践ガイドで扱っています。この記事が扱うのは、絞り込みURL固有の分岐だけです。
残す組み合わせの決め方|検索語と在庫がある所だけ、条件は2つまで
残す組み合わせとは、検索結果に出す前提でインデックスを許可し、中身を作り込む絞り込みURLのことです。
判断の基準は4つあります。上から順に見て、1つでも欠けたら残さない側へ回します。この4つは公式ドキュメントに書かれた基準ではなく、運用側で決める判断の線引きです。
1. その条件が、人が実際に検索する言葉になっているか。「ワンピース 黒」は言葉として成立しますが、「ワンピース 3,000円〜5,000円 新着順」は検索窓に入力されにくい。判断材料は、Search Consoleのクエリ、サイト内検索ログ、接客や問い合わせで実際に使われている言い回しです 2. その条件に、継続して在庫があるか。季節で在庫が消える条件を残すと、結果0件のページが検索結果に残ります 3. そのページに、一覧以外の説明を足せるか。選び方、サイズ感、用途の違い。書けないなら、残す理由が弱い 4. 重ねる条件は2つまで。3つ重ねた時点で、指名で検索される言葉からは離れていきます
残さない側の典型も挙げておきます。
- 並び替え(価格の安い順、新着順)。中身が同じで順番だけが違うページは、公式もブロック対象の例として挙げています
- 1ページあたりの表示件数の切り替え
- 在庫あり・なしの切り替えのように、時間で結果が変わるフィルタ
- セッションIDや広告のトラッキングパラメータ。これらは内部リンクから外すのが基本です
EC運営の現場では、絞り込み条件は要望が出るたびに増えていきます。「この色でも絞れるようにしてほしい」という依頼は通りやすく、「この条件、もう消しましょう」と言い出す人はいない。18年以上ECとSEOの運用に関わってきて、絞り込み条件が自然に減っていく場面は、まず見ていません。
止める材料も、その場では出せませんでした。消したところで売上が増えるわけではなく、残して何が困るのかを一言で説明できない。判断を先送りしている自覚だけが残り、結論は次の打ち合わせへ回っていきます。決め方を持っていなかった、というのが正直なところです。
実際に起きたのは、商品数は変わらないのに、一覧ページのURLだけが増え続ける状態です。どのパラメータが生きているのかを一覧で持っている人がいないため、「検索結果に出したいのはどれですか」と聞かれても即答できません。増えたものは、誰かが意図して整理しない限り、そのまま残り続けます。
ここまでの4つの基準は、その時に手元になかったものを、あとから言葉にしたものです。
増やす判断には理由がつき、減らす判断には誰も理由をつけない。
URLの書き方を揃える|順序・区切り・重複・0件のとき
URLの正規化とは、同じ中身が複数のURLで表示されないよう、書き方を1つに固定することです。
公式が示している具体ルールは、実装に落とせる粒度で書かれています。Designing a URL structure for ecommerce websitesと、前出のファセットナビゲーションのドキュメントを合わせると、次のようになります。
- パラメータの区切りは & を使う。カンマ、セミコロン、角かっこは、区切り記号として認識されにくい
- ?color=green のように、キーと値の形にする。?green のような値だけの書き方は避ける
- 同じパラメータ名を1つのURLに2回書かない。複数の値を渡すなら、1つのパラメータの中にまとめる
- パスに絞り込みを埋め込むなら(/products/fish/green/tiny のような形)、条件の並び順を常に同じにし、同じ条件が重複して入らないようにする
- 大文字と小文字をサーバー側で同一視しているなら、URL上の表記も片方に揃える
- 内部リンクとサイトマップとcanonicalで、同じURL表記を使う
- セッションID、時刻、「近くの」のようなユーザー依存の値へ、内部リンクを張らない
順序を揃える話は、実装の決め方に直結します。テンプレートの各所でURLを文字列結合していると、並び順は必ずばらけます。絞り込みURLを組み立てる処理を1か所に集約し、そこで条件を決まった順番に並べてから出力する。触る場所が1つになれば、順序の揺れは構造的に起きなくなります。
もうひとつ、忘れられがちなのが0件のときの応答です。公式は、条件の組み合わせに該当する商品がない場合、共通のエラーページへリダイレクトせず、そのURLのまま404を返すよう求めています。条件が重複しているURLや、存在しないページ番号のURLも同じ扱いです。緑色の魚が在庫にないなら、利用者にもクローラーにも「ありません」と返す。ここを200で返して空の一覧を出し続けると、無意味なURLが資産のように扱われます。
なお、Search ConsoleのURLパラメータツールは、2022年3月の告知を経て廃止されました。Spring cleaning: the URL Parameters toolによれば、当時ツールに登録されていたパラメータ設定のうち、クロールにとって有用だったのは約1%。以後の制御は、robots.txtのルールで行うよう案内されています。管理画面で指定する場所を探していたなら、もう存在しません。
ページネーションとの噛み合わせ|2ページ目以降をどう扱うか
ページネーションとは、長い一覧を複数のページに分けて表示する仕組みのことです。絞り込みと掛け合わさると、URLはさらに増えます。
Pagination, incremental page loading, and their impact on Google Searchに書かれている内容のうち、絞り込みと関係するのは次の点です。
- 連番の各ページに、固有のURLを持たせる。?page=2 のようなクエリパラメータで構わない
- 連番の1ページ目を、2ページ目以降のcanonicalに指定しない。各ページには、そのページ自身を指すcanonicalを置く
- ページ番号を # 以降で表さない。Googleはフラグメントを無視するため、次ページへのリンクをたどらない可能性があります
- rel=”next” と rel=”prev” を、Googleはすでに使っていません。他の検索エンジンが使っている可能性は残ります
- 各ページから次のページへ a href でリンクする。あわせて、各ページから1ページ目へ戻るリンクを置くことも検討する
- 連番ページのタイトルと説明文は、同じでも構いません。通常の「ページごとに変える」という推奨は、ここには当てはまらないと明記されています
- フィルタや並び替えのバリエーションについては、noindexかrobots.txtでインデックスを避けるよう書かれています
ここから先は、自社で決める部分です。クロールさせないと決めた条件は、条件ごとブロックされるので、その配下のページネーションを個別に考える必要はありません。問題は、残すと決めた条件の2ページ目以降です。
公式からはっきり言えるのは、2ページ目を1ページ目へcanonicalで寄せるのは避ける、という点だけです。残す条件の2ページ目以降をnoindexにすべきかどうかは、公式ドキュメントに明示がなく、この記事では断定できません。商品数が多くて2ページ目以降にも独自の価値がある店と、5件しか差がない店とでは判断が変わります。まずは自己参照canonicalのまま様子を見て、Search Consoleの「検出 – インデックス未登録」に連番URLが積み上がるようなら、その時点で絞る。この順番なら、取り返しのつかない操作をせずに済みます。
残すと決めたURLに何を書くか|商品グリッドだけでは足りない
絞り込みページの中身とは、そのページが検索結果に出る根拠になる、一覧以外のテキストと導線のことです。
残すと決めたURLは、インデックスされる可能性が出ます。ただし、出るかどうかはGoogleの判断であり、こちらで決められるのは中身の側だけです。商品が並んだグリッドだけのページは、条件違いのページと見分けがつきません。何をもって「このページを出す価値がある」と判断してもらうのか、という問題が残ります。
入れる要素は、多くありません。
- その条件で探している人に向けた見出しと、短い導入文
- 選び方の説明。黒のワンピースなら、生地の違いや用途、サイズ選びの注意点
- 関連する条件への導線。近い条件のページへ、a href でリンクする
- パンくず。今どの階層にいるかを、利用者とクローラーの両方に示す
条件名だけを差し替えた自動生成文でも形は作れます。ただ、色名だけが入れ替わった数十ページが並んだとき、そこに差が出るかどうかは期待しにくい。書き分けられる条件に絞る、という4番目の基準がここで効いてきます。
中身を整えれば必ず順位がつく、という話ではありません。整えていないページが選ばれる理由がない、という話です。
今日からの3ステップ|棚卸し・3分類・確認
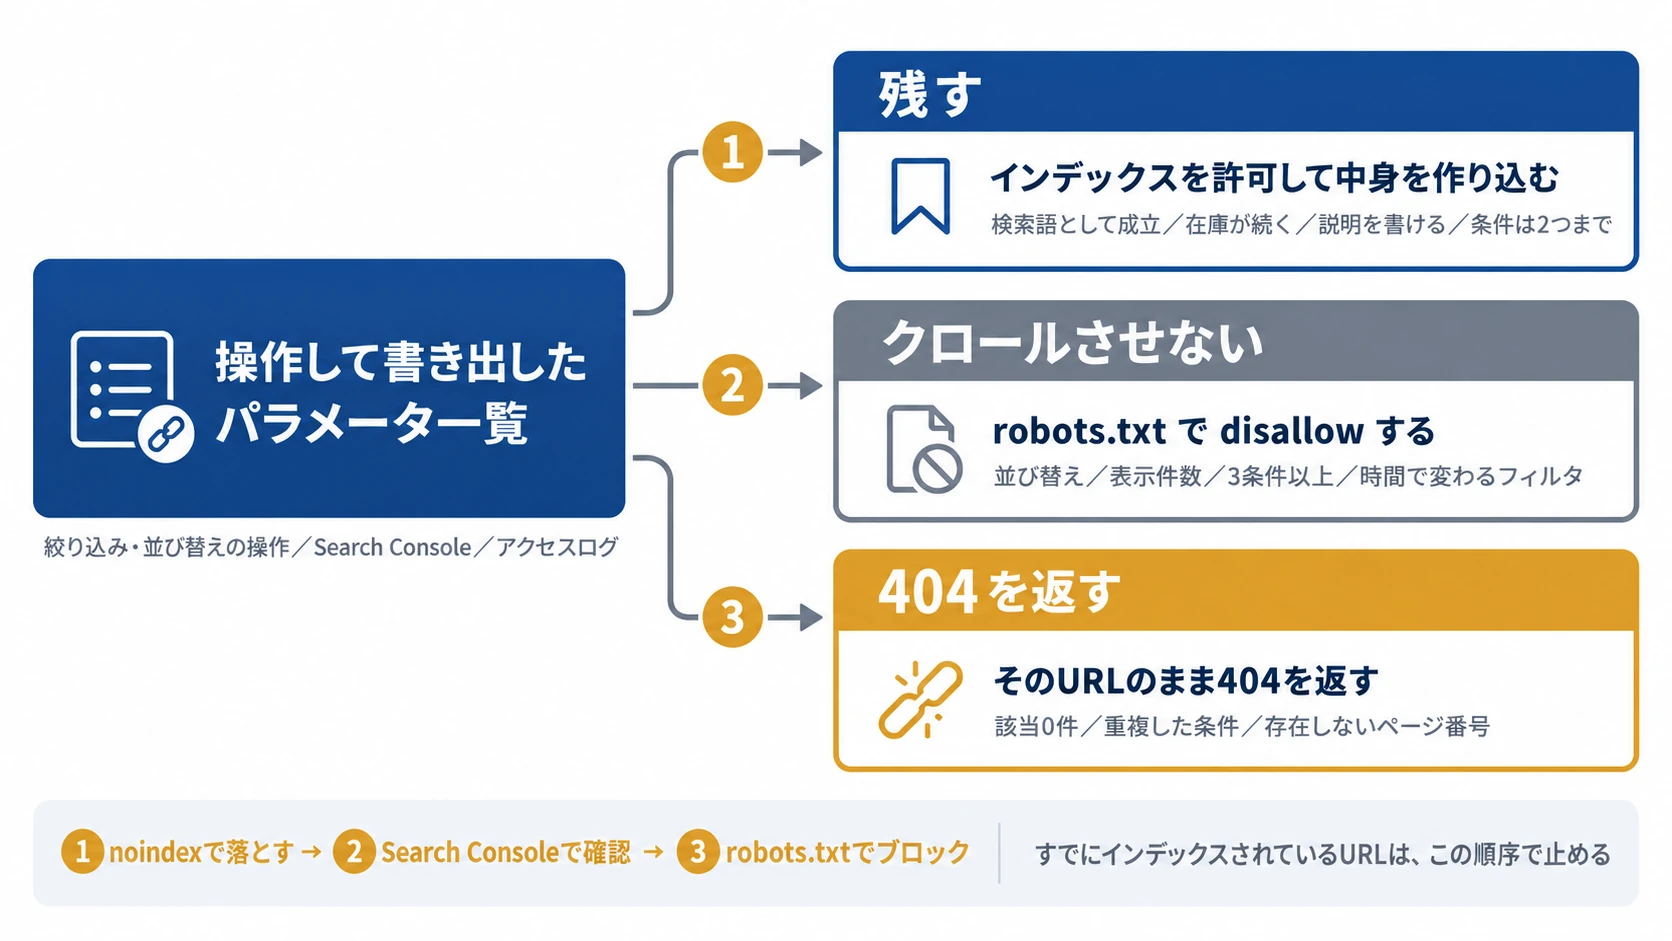
棚卸しとは、自社のECが実際に生成しているURLのパターンを、すべて書き出して一覧にする作業です。ここを飛ばすと、知らないパラメータが残り続けます。
ステップ1は、パラメータの書き出しです。自社サイトで絞り込み検索と並び替えを実際に操作し、アドレスバーに出るパラメータ名を記録します。あわせて、Search Consoleのページ インデックス登録レポートに出ているURLと、サーバーのアクセスログに残っているパラメータも拾ってください。広告用のパラメータや、過去のリニューアルで残ったものが、ここで出てくることがあります。
ステップ2は、3分類です。書き出したパターンを、次の3つに振り分けます。
- 残す: 検索語として成立し、在庫が続き、説明を書けて、条件が2つまで
- クロールさせない: 並び替え、表示件数、3条件以上の組み合わせ、時間で変わるフィルタ
- 404を返す: 該当0件の組み合わせ、重複した条件、存在しないページ番号
ステップ3は、反映と確認です。robots.txtでブロックする場合は、Googlebot向けに対象パラメータのパターンをdisallowで指定し、フィルタなしの一覧ページはallowで開けておきます。書いたあとは、Search Consoleのrobots.txtレポートとURL検査で、意図した通りにブロックされているかを1件ずつ確かめるとよいでしょう。
注意すべき順番があります。すでに大量のパラメータURLがインデックスされている状態で、いきなりrobots.txtでブロックすると、クローラーはそのページを取得できなくなり、noindexも読めなくなります。公式の記述から導けるのは、先にnoindexでインデックスから落とし、落ちたことをSearch Consoleで確認してから、robots.txtでクロールを止める、という順序です。まだインデックスされていないなら、最初からブロックで構いません。
確認の窓は、公開後28日を目安にします。Search Consoleでパラメータ付きURLの表示回数と、「検出 – インデックス未登録」の件数が、どう動いたかを見る。数字が動かない場合に何を変えるかまで決めておくと、手が止まりません。
決めたルールは崩れる|一度の整理で終わらせない
絞り込み検索のURL運用とは、一度決めた分類を、商品やサイトが変化しても保ち続ける仕組みのことです。
ここまでの手順は、自社でひととおり実行できます。ただ、続くかどうかは別の話です。新色が追加され、セール用のパラメータが増え、広告代理店が新しいトラッキングパラメータを付け、サイトリニューアルでURL設計ごと変わる。そのたびに、決めたルールは静かにずれていきます。しかも、ずれてもエラーは出ません。サイトは普通に動いたまま、検索結果に出したくないURLだけが増えていきます。
だから、確認の起点をパラメータ一覧の側に置いておく必要があります。新色が1つ追加された日に、誰かがrobots.txtを思い出す前提の運用は、その日のうちに破れる。Mirai&でも、公開記事の一覧とサイトマップの突合を、人が見に行かなくていい形にしてあります。
Mirai&のAI人格® Web運用も、記事を書いて終わりにする作りにはしていません。会社の強みや言葉遣いを学習したAI人格が、キーワードの設計から記事の作成、入稿、公開後に何がずれたかを見る工程までを担当し、経営者の仕事は承認だけになります。導入企業ではアクセスが5.4倍、新規記事の上位表示率は70%という実績がありますが、同じ成果を約束できるものではありません。
絞り込みURLの整理も、単発の作業として終わらせるのか、毎月回る運用に組み込むのかで、半年後の状態が変わります。自社の絞り込み条件をどう分類すべきか迷っているなら、無料相談で現状を見せてください。しつこい営業はしません。
よくある質問
絞り込みページはすべてnoindexにしておけば安全ですか
安全ではありますが、クロールの負荷は減りません。noindexは、クローラーがページを取得してタグを読んでから除外する仕組みのため、クロール自体は発生します。公式も、クロール量を減らす目的でnoindexを使わないよう明記しています。クロールを止めたいならrobots.txt、検索結果から消したいならnoindex、と目的で使い分けてください。
robots.txtでブロックすれば検索結果からも消えますか
確実ではありません。robots.txtはクロールを止めるものであり、インデックスからの削除を指示するものではないからです。ブロックされたURLは、他サイトからリンクされている場合などに検索結果へ表示され得ると公式に書かれています。すでにインデックスされているURLを消したい場合は、先にnoindexで落とし、落ちたことを確認してからブロックする順序になります。
絞り込みURLにcanonicalを付けるだけでは足りませんか
足りるかどうかは、サイトの規模とURL数によって変わるでしょう。公式のファセットナビゲーションの解説では、canonicalやnofollowは、robots.txtやURLフラグメントによる方法と比べて長期的には効果が薄いと説明されています。また、canonicalはあくまでヒントであり、Googleが別のURLを正規版として選ぶこともあると明記されています。URL数が少ないうちは機能しますが、数千規模になってからの主軸にはしにくい手段です。
パラメータよりパス形式のほうがSEOに有利ですか
公式にどちらが有利と書かれた記述は確認できません。商品バリエーションのURLについては、パス形式(/t-shirt/green)もクエリパラメータ形式(/t-shirt?color=green)も、どちらも推奨として並記されています。ただしパス形式を選ぶ場合は、条件の並び順を常に同じにし、重複した条件が入らないようにする必要があります。既存の実装を変えるコストに見合うかどうかで判断してください。
絞り込みページを残すと商品ページと食い合いませんか
条件の絞り方次第です。「黒のワンピース」のように複数商品を比較したい検索と、特定の商品名で探す検索は、求めているページが違います。一方で、条件を3つ重ねて該当商品が1点しかないページは、その商品ページと役割が重なるでしょう。残す条件を2つまでにし、商品数が一定以上ある条件だけを残す、という基準はここにも効いてきます。
まとめ|今日決める3つ
やることは3つです。順番も含めて、そのまま使えます。
1. 判定する。Search Consoleのページ インデックス登録レポートを開き、「検出 – インデックス未登録」にパラメータ付きURLが並んでいるかを見る。並んでいなければ、今日は触らなくていい 2. 分類する。実際に操作してパラメータを書き出し、残す・クロールさせない・404を返す、の3つに振り分ける 3. 確認する。反映後にURL検査で1件ずつ確かめ、28日後にもう一度レポートを見る。すでにインデックスされているURLは、noindexで落としてからブロックする
絞り込み検索は、増やすときには理由がつき、減らすときには誰も理由をつけません。だから、判断の基準を先に決めておく。ルールがあれば、次に新色が増えた日も、迷わず同じ場所に振り分けられます。
自社の条件をどう分けるべきか、実物を見ながら整理したい場合は、無料相談からご相談ください。現状の絞り込みURLがどう扱われているかを確認したうえで、優先順位をお伝えします。